
企业把安全运营外包给服务商,买的是省心。但做过几轮MSS采购的客户,常有一个隐忧:服务质量取决于服务商派的人。
这个隐忧不是多虑。传统MSS本质上是人力堆砌,服务水平系于值班工程师的个人经验。骨干一走,质量就波动;客户量一涨,服务商只能线性加人,成本转嫁回来,性价比迅速恶化。
客户端的困境也在加剧。安全人才招不到、留不下,集团多分支能力参差不齐;设备买了不少,日志告警散在各处,海量告警没人筛,也筛不动;安全建设重交付轻运营,防护效果逐年衰减,圈子里叫“建完即衰”。
供给侧和需求侧的问题,其实是同一个:安全运营能力没有沉淀成体系,只长在人脑里。我们做了多年托管服务,给出的答案是知识工程驱动的体系化运营,把专家经验萃取成可复用、可迭代的标准化知识资产,让服务质量由体系保障,而不是由某个人的状态决定。这也是我们对MSS的定位:客户专属的云端安全运营中心,全面承接监测、研判、处置、风险管理和防护运维。
知识工程不是概念包装,它有明确的运转机制:生产、标准化、落地、迭代,四步成环。
生产环节,专家团队持续跟踪威胁态势和攻防技术,更要紧的是从每一次实战中萃取经验。一次挖矿处置、一次钓鱼溯源、一次漏洞应急,都是知识的原料。
标准化环节,把碎片经验转化成可执行的资产:检测规则库、处置剧本库、操作规范、交付模板。一个事件怎么看、怎么判、怎么处置、怎么通报,全部落成书面标准,有版本管理。
落地环节,知识不能躺在文档里。检测规则直接配进运营平台,处置流程固化为工单节点,操作规范进入培训与考核,用技术约束和流程指引保证无论谁值班,动作不走样。
迭代环节,处置复盘和客户反馈定期回流,找出规则盲区和流程瓶颈,优化成果重新沉淀进知识体系。能力跟着威胁演进,而不是跟着人员流动流失。
这套机制解决的是MSS行业最根本的矛盾:服务质量可复制。知识每多覆盖一类场景,新人的成长周期就短一截,不同客户、不同班次之间的水准就拉齐一分。
让方法论落地:平台、流程、团队
知识工程要转起来,需要三个载体。
平台是知识的固化器。我们依托一体化运营平台承载全部托管作业:多源日志统一接入、范式化解析,智能引擎做告警降噪、关联聚合和误报过滤;标准处置流程转成自动化剧本,一键触发、全程留痕、可回滚;所有工作以工单流转,SLA时效平台自动统计、超时自动预警。客户通过门户实时看态势、追工单、取报告,服务全程透明,不用等到月底才看一份总结。
流程是传送带。告警分诊、事件处置、漏洞全生命周期管控、应急响应、报告交付,每个核心场景都有标准作业流程,分级升级和跨团队协同机制清楚,不留职责空白。常态化复盘保证流程本身也在迭代,形成执行、复盘、优化、再落地的正循环。
团队是执行者。运营中心用三级梯队:T1值守岗做7×24监控和告警分诊,T2运营岗做事件深度研判与处置闭环,T3专家岗做高危事件攻坚、规则优化和能力沉淀。最小可交付单元是7个人,T1四人、T2两人、T3一人,可以稳定支撑日均500到800条有效告警的运营。分工让不同难度的问题各归其位,专家的时间不再耗在初级筛选上。
标准化到什么程度?看交付就知道
方法论是不是真存在,交付环节是最好的试金石。拿威胁事件运营服务来说,一个新客户接入被拆成启动、接入部署、联调测试、试运行、移交五个标准阶段,每个阶段都有核查清单和量化验收线:
-
约定范围内日志源接入率100%,核心字段解析准确率不低于95%
-
日志丢包率不超过1%,从产生到平台展示的平均延迟不超过5分钟
-
试运行期持续压降误报,告警降噪压缩比不低于80%
-
通用场景误报率控制在20%以内,连续14天核心SLA达标率不低于95%,才结束试运行,正式承诺SLA
每一项都有据可查、有痕可溯。知识工程还有另一面:它不只沉淀怎么干活,也沉淀怎么算干好。服务质量第一次变得可以量化承诺、可以独立验证。
边际成本为什么递减
体系化运营的商业价值,最后体现在成本曲线上。传统MSS的成本随客户数线性增长,知识工程模式下有三股力量把曲线压弯。
一是知识复用。检测规则、处置剧本、交付模板跨客户复用,新客户的场景适配成本随知识库完善不断降低。二是自动化替代。高频重复动作被剧本接管,自动化覆盖率每提升10%,对应岗位的人力承载能力能提升10%到15%。三是规模摊薄。同类告警、同类事件批量处置,效率随接入规模一起涨。
行业基准也能佐证。成熟运营中心的人均效能大致是:T1值守岗日均处理有效告警300到500条,T2运营岗日均闭环处置事件8到15起。体系化程度越高,达成这些基准线越不靠招到厉害的人,而是靠体系把人武装到位。
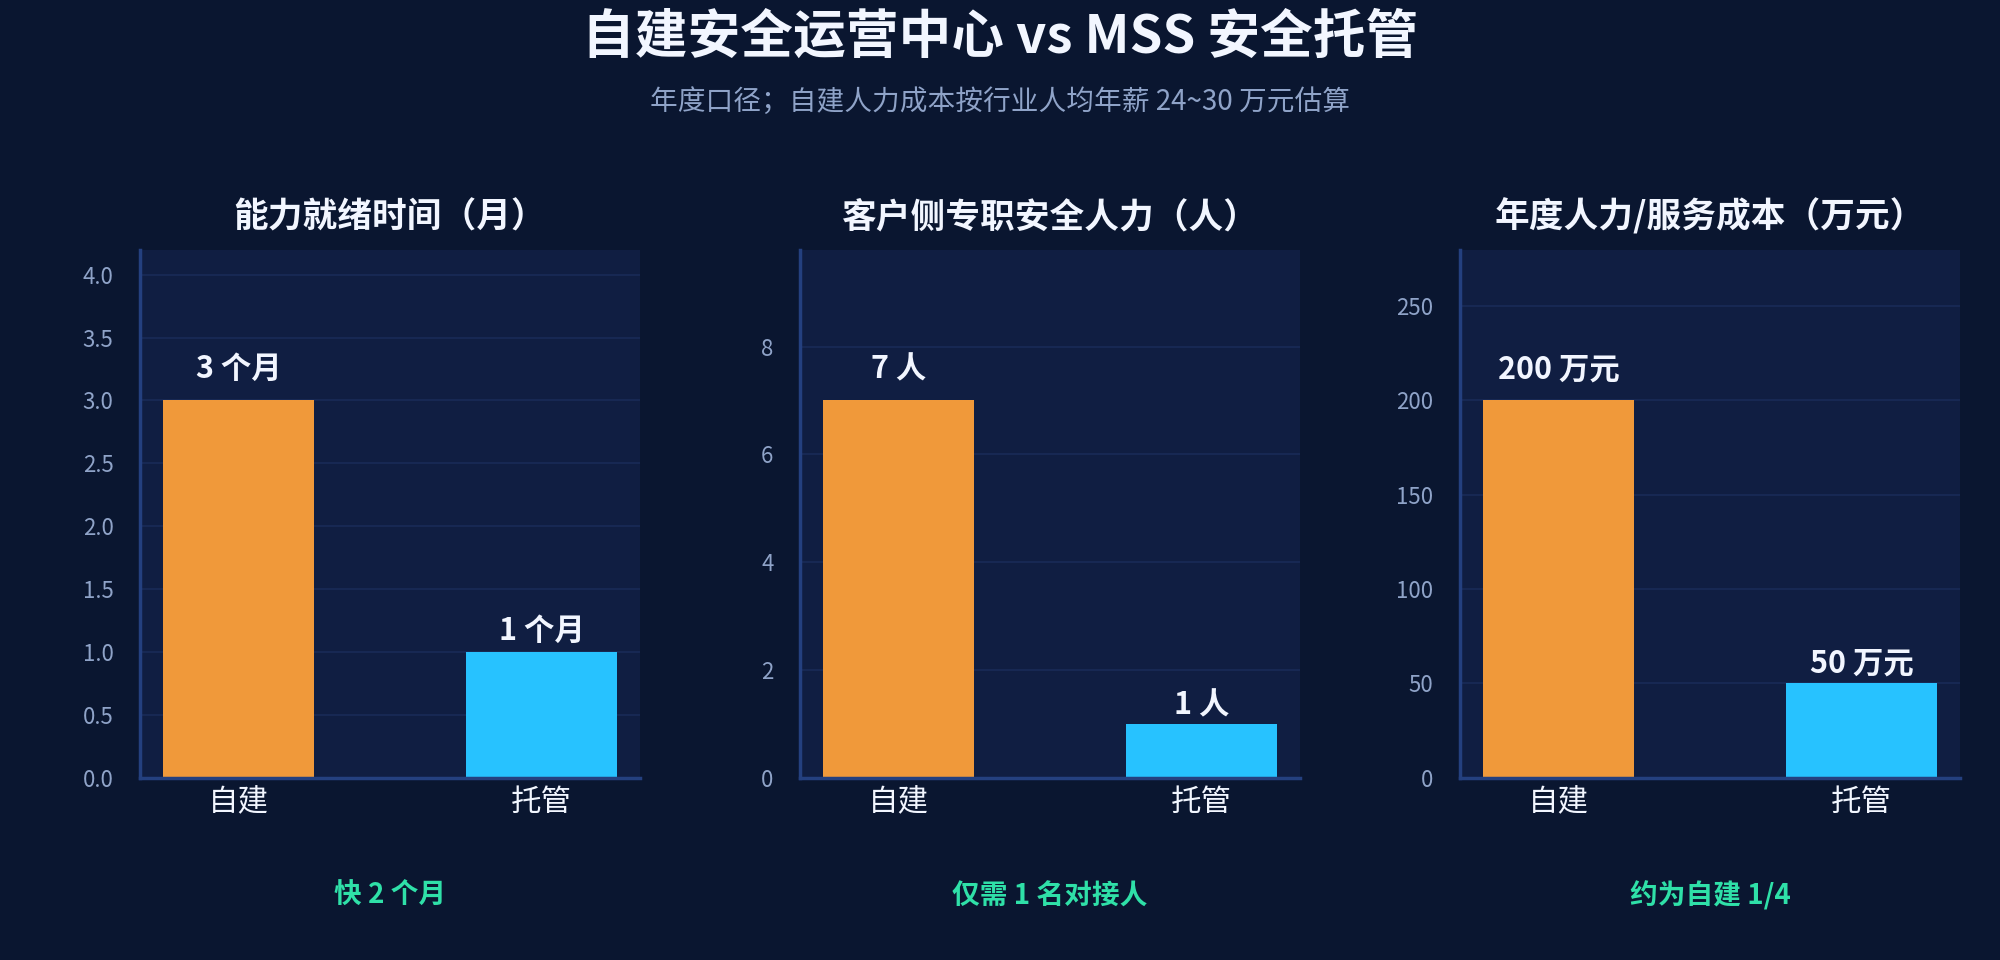
自建和托管的差异,用数字说更直接(成本为年度口径,自建人力成本按行业人均年薪 24-30 万元估算):
|
对比项 |
自建安全运营中心 |
MSS 安全托管 |
|
能力就绪时间 |
约 3个月(能力爬坡期) |
标准客户 1个月试运行即达正式SLA |
|
客户侧专职安全人力 |
至少 7人(三级梯队最小闭环) |
1人(对接联系人) |
|
年度人力/服务成本 |
仅人力约 170-210万元,不含平台建设投入 |
数十万元级,约为自建的四分之一到十分之一 |
|
7×24值守覆盖 |
夜间与周末空窗期普遍存在 |
三线梯队轮值,全天候覆盖 |
|
人均告警处理效能 |
依赖招聘水平,参差不齐 |
T1岗日均 300~500条(行业成熟基准) |
一所高校的托管一年
方法论的价值成色,客户现场结果印证。说一个某高校的托管项目。
该校的处境很典型:安全日志爆发式增长,值班老师很难从海量日志里找出真实攻击;网站监测靠人工巡查,效率低、盲区多;安全工作没有度量,年终汇报拿不出硬材料。
托管接入后,运营团队在现有基础上部署了流量检测设备,把分散设备的日志统一接进云端运营平台,用关联分析规则做聚合降噪和统一监控,事件从发现到响应形成闭环。网站群那边,启用自动化监测,周期性扫描全部链接和页面内容,恶意变更即时告警、联动恢复,人工盯防被替掉,成本反而低了。
跑了一年,三个老问题各有答案。日志降噪之后,真实攻击浮出水面;网站监测从人工转成自动化,效率是质的差别;年度安全事件报表完整呈现了处置量、响应时效和风险趋势,安全成果第一次便于汇报。后来这套模式复制到多所院校,交付质量保持一致。这正是知识工程想要的证明:能力在体系里,不在某个人身上。
托管前后的对比整理成表,看得更清楚:
|
维度 |
托管前 |
托管后 |
|
日志研判 |
值班老师人工筛查,日均约 2 小时,真实攻击难以发现 |
云端降噪后聚焦数百条有效告警,研判有的放矢 |
|
网站监测 |
人工每日巡查 1 次,存在盲区 |
7×24 自动化周期扫描,恶意变更即时告警并联动恢复 |
|
事件响应 |
依赖个人经验,响应以小时计 |
标准化工单流转,高危事件分钟级响应 |
|
年度安全汇报 |
无量化数据,年终拿不出硬材料 |
全年处置安全事件 300 余起,平均响应约 15 分钟,全部量化呈现 |
结语
安全托管做到最后,拼的不是谁人多,而是谁的体系厚。专家经验持续转化成规则、剧本和标准,每次处置都在给知识库增值,服务质量就不再依赖个体,成本曲线也随之下降。知识工程说白了是个朴素的道理:让经验留在体系里,让体系扛住日常,人腾出手来对付真正未知的威胁。这是我们对MSS下一程的理解,也是正在规模复制的做法。
